Des frontières explicites
Modules et services portent un vocabulaire et des invariants compréhensibles par le produit et la technique.
pour vos applications métiers et reprises complexes
Novatis conçoit, développe et reprend des applications Symfony : domaine métier, interfaces, API, messages, données, tests, migrations, CI/CD, déploiement et maintenance sont traités dans une même trajectoire.
La reprise commence par le comportement à préserver, les risques et les dépendances. Le projet livre ensuite du code testable, une architecture documentée et une procédure de mise en production reproductible.
Modules et services portent un vocabulaire et des invariants compréhensibles par le produit et la technique.
Appels externes, événements et traitements asynchrones disposent d’états, de reprises et d’une trace.
Tests, migrations, configuration et déploiement réduisent les différences entre code validé et production.
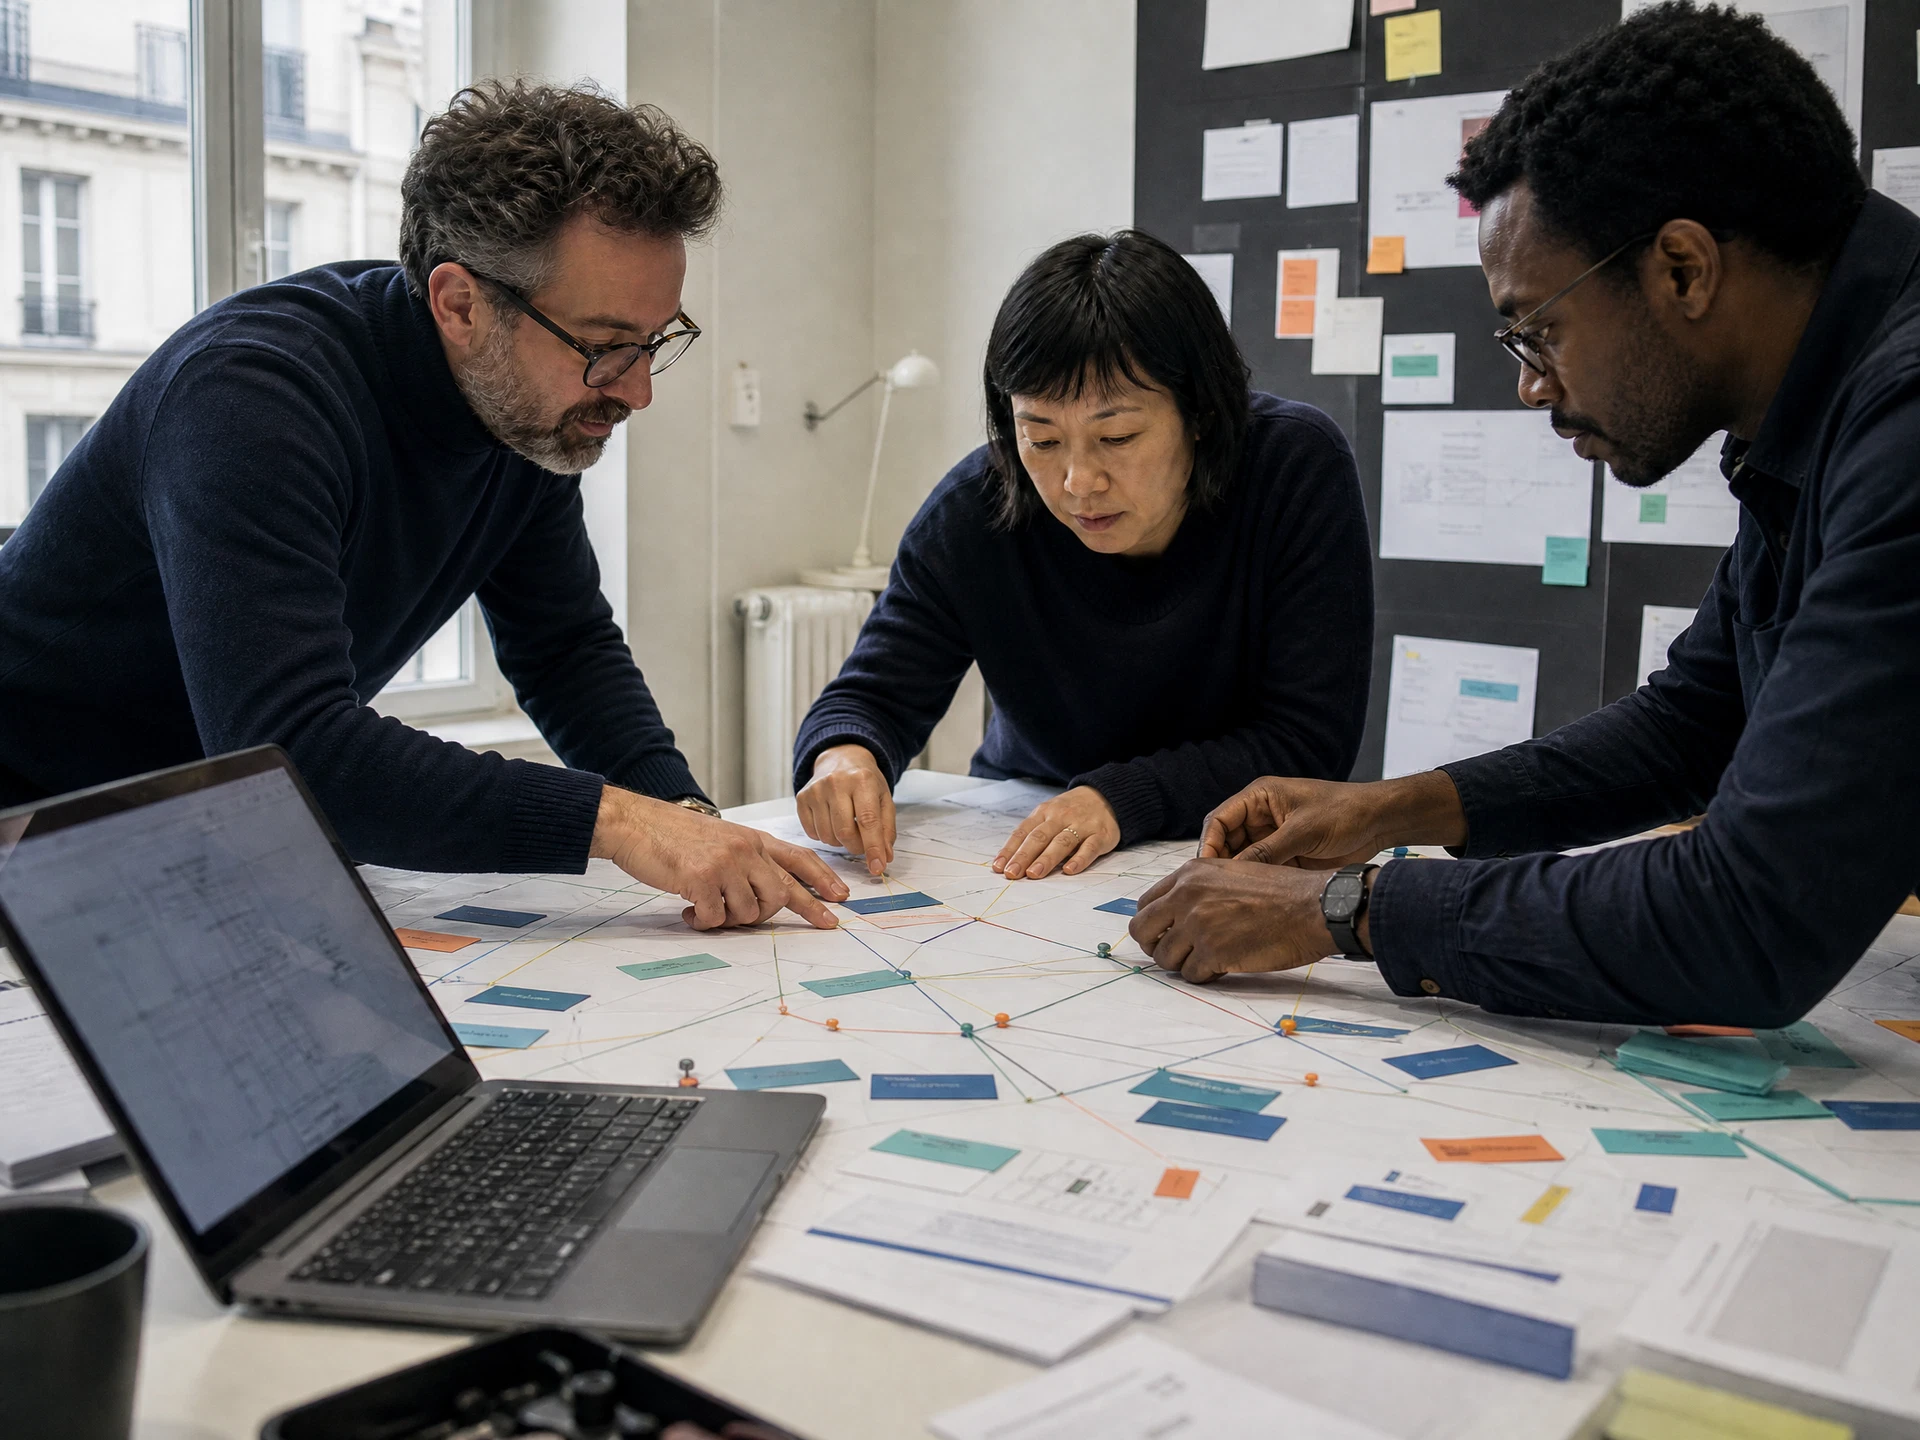
Nous travaillons avec les experts du domaine pour distinguer objets, règles, événements et responsabilités. Cette carte évite que contrôleurs, entités ou services deviennent des réceptacles universels.
La modernisation avance ensuite par frontières : sécuriser un scénario, isoler une dépendance, ajouter une interface et rendre le déploiement reproductible.
Chaque étape protège un scénario métier puis réduit la dette qui empêche son évolution.
Règles, données, acteurs, intégrations et incidents identifient les zones critiques.
La qualité apparente du code ne révèle pas seule les contrats métier et opérationnels qu’il faut préserver.
Ils capturent les scénarios critiques avant refactorisation, y compris lorsque le comportement actuel contient des compromis à traiter plus tard.
Transport, idempotence, erreur, reprise et ordre sont conçus avec le métier qui dépend du traitement.
Secrets, environnements, services et migrations doivent produire une application reproductible plutôt qu’une production unique.
Novatis intervient avec les responsables métier et technique à Paris ou à distance. Le plan peut combiner stabilisation, montée de version, nouvelle fonction, extraction d’un module ou reprise progressive.
Modèle métier, services, interfaces, API, messages, administration et intégrations sont construits autour de scénarios et critères testables.
Versions, dépendances, architecture, données, tests, sécurité, performance, déploiement et incidents établissent les risques et l’ordre d’intervention.
Tests de caractérisation, frontières, contrats, migrations et observabilité permettent de remplacer les zones bloquantes sans arrêter l’ensemble.
Le budget dépend de l’âge et de l’état du patrimoine, des scénarios critiques, des données, des versions, des intégrations et des exigences de production.
Dépôt, configuration, environnements, contrats d’interface, messages, migrations, procédures, accès et décisions importantes sont remis selon le périmètre. Les équipes peuvent poursuivre avec Novatis ou organiser une reprise.
Accès, procédures et responsabilités explicitésCes articles complètent la page avec des repères de choix, de méthode ou d’exploitation.
Ces témoignages sont reproduits fidèlement depuis la fiche Google publique de Novatis. Ils parlent de qualité d’exécution, de réactivité et, surtout, de relations qui continuent bien après une première mise en ligne.
« Je travaille avec NOVATIS depuis plus de 15 ans. NOVATIS a fait une dizaine de sites internet pendant ces 15 ans pour mes sociétés, en langues française, anglaise et chinoise. NOVATIS est fiable et compétitif, et la communication est facile avec eux. 100% satisfait. »
« Une agence efficace et centré sur l’humain, j’ai sollicité l’agence Web Novatis pour la création de mon site internet et le référencement SEO, disponibilité, écoute, professionnalisme. Je recommande les yeux fermés. »
« Agence pro à des tarifs très compétitifs. Nous avons réalisés plusieurs sites avec eux qui marchent très bien. »
« Très bonne expérience avec Novatis. L’équipe se distingue par son professionnalisme, sa réactivité et son souci du détail. Le site livré est moderne, rapide et parfaitement structuré. Je recommande vivement. »
Source : fiche Google « NOVATIS: Agence Web France », consultée le 7 octobre 2026. Note publique observée : 5,0 sur 5 pour 7 avis.
Les choix de socle, d’architecture, d’administration et de maintenance dépendent de l’existant, des usages et de votre équipe. Ces réponses donnent un cadre sans remplacer l’étude.
Poser une autre questionPour des applications durables où la structure compte : composants indépendants, configuration explicite, injection de dépendances et conventions qui tiennent sur plusieurs années.
Ce que Symfony achète vraiment est la prévisibilité. La structure est imposée, la configuration est déclarée, les dépendances sont injectées explicitement : deux développeurs qui n’ont jamais travaillé ensemble écrivent un code comparable. Sur un produit maintenu cinq ou dix ans, avec des équipes qui changent, c’est l’argument décisif.
La contrepartie est un démarrage plus lent. Ce qui prend une heure ailleurs en prend trois ici, parce qu’il faut déclarer plutôt que deviner. Sur un périmètre à livrer en deux mois, cela pèse ; sur un produit à cinq ans, cela se rembourse à la première reprise.
Symfony s’impose aussi par son cycle de support : les versions à support long reçoivent des correctifs pendant plusieurs années, ce qui permet de planifier les montées au lieu de les subir. Nous recommandons Symfony quand le domaine est riche en règles, quand plusieurs développeurs interviendront, ou quand la durée de vie attendue dépasse trois ans.
Oui. Les montées de version se planifient par étapes, avec analyse des dépendances, des composants obsolètes et des points de rupture.
La méthode est toujours la même : une marche à la fois, jamais un saut. Passer d’une version ancienne à la version courante en une opération est ingérable — on cumule les ruptures de plusieurs versions et on ne sait plus laquelle a cassé quoi. On monte donc version par version, avec la suite de tests comme filet à chaque palier.
Quand les tests n’existent pas, le premier lot consiste à en écrire assez pour couvrir les parcours critiques. C’est un investissement qui paraît retarder le chantier et qui le raccourcit : sans lui, chaque palier demande une recette manuelle complète.
Le travail préparatoire consiste à traiter les avertissements de dépréciation de la version en cours avant de monter. Ils annoncent exactement ce qui va casser, et les résoudre sur la version stable est beaucoup plus confortable que de les découvrir après la montée.
Comptez un à trois jours par palier majeur sur une application de taille moyenne.
Rarement en totalité. Une reprise progressive, module par module, réduit le risque et permet de continuer à livrer pendant la modernisation.
La réécriture complète échoue pour une raison structurelle : pendant qu’elle avance, l’ancien système continue d’évoluer, et il faut reporter ces évolutions dans le nouveau. Le double travail s’accumule, la date de basculement recule, et le projet meurt avec deux systèmes à maintenir.
L’approche progressive consiste à placer le nouveau devant l’ancien et à déplacer les routes une par une : la page réécrite est servie par le nouveau code, les autres passent par l’ancien. Les utilisateurs ne voient rien, et chaque module livré apporte un gain immédiat.
Elle demande deux choses : une base de données partagée pendant la transition, ce qui impose de la discipline sur les écritures ; et l’acceptation d’une période où deux socles cohabitent, ce qui est inconfortable et beaucoup moins risqué qu’un basculement unique.
Nous chiffrons module par module, dans l’ordre de ce qui bloque le plus d’évolutions.
Pour découpler les traitements : messages, files, réessais et supervision, afin que les tâches longues ou dépendantes d’un tiers ne bloquent pas l’utilisateur.
Le schéma type : une action utilisateur émet un message, la réponse part immédiatement, et un processus distinct traite le message. Un envoi de courriel, une génération de document, un appel à un service externe, un import de fichier deviennent ainsi asynchrones.
Les réglages qui comptent sont ceux de l’échec. Un nombre maximal de tentatives avec un intervalle croissant, pour ne pas marteler un service en panne. Une file d’échec qui conserve les messages non traités, avec un destinataire nommé alerté au-delà d’un seuil. Et l’idempotence des gestionnaires, pour qu’un message rejoué ne produise pas deux fois l’effet.
La supervision est le point qu’on oublie : il faut savoir combien de messages attendent, depuis combien de temps, et lesquels ont échoué. Sans cette visibilité, une file bloquée passe inaperçue pendant des jours — c’est l’incident silencieux le plus fréquent sur ce type d’architecture, et nous exposons donc ces compteurs dans l’administration.
Oui. Les interfaces sont conçues avec des contrats explicites, une sérialisation maîtrisée, une authentification adaptée, des versions et des tests.
Symfony s’y prête bien parce que la sérialisation et la validation sont déclaratives : ce qui sort de l’interface est décrit par des groupes plutôt que construit à la main, ce qui évite les fuites de champs internes — l’erreur la plus courante et la plus discrète, où un objet sérialisé emporte un champ qu’on ne voulait pas exposer.
Les décisions structurantes se prennent avant la première livraison : le mode d’authentification selon le consommateur, la version dans l’adresse dès le départ, la forme uniforme des erreurs avec un code stable, la pagination obligatoire, et la limitation de débit par consommateur.
La documentation est générée depuis le code et les annotations, pas rédigée séparément : une documentation manuelle se désynchronise en quelques semaines et devient pire que rien.
Les tests couvrent les cas d’erreur autant que les cas nominaux, et en particulier les appels sans autorisation — c’est ce qui se vérifie le moins et ce qui expose le plus.
Analyse statique, tests automatisés, vérification du style, audit des dépendances et déploiement reproductible avec possibilité de retour arrière.
À chaque proposition de modification, la chaîne exécute dans l’ordre : le style de code, l’analyse statique qui détecte les erreurs de type avant l’exécution, les tests unitaires, les tests fonctionnels sur une base reconstruite, et un audit des dépendances signalant les paquets à failles connues. Une modification qui échoue à l’une de ces étapes ne peut pas être fusionnée.
Le déploiement est scripté et rejoué à l’identique sur la préproduction puis la production, avec les migrations de base appliquées dans le même mouvement. Le retour arrière est prévu et testé : c’est la partie qu’on écrit et qu’on ne vérifie jamais, ce qui la rend inutile le jour où elle sert.
Ce que cela coûte : un à trois jours de mise en place selon l’hébergement. Ce que cela évite : les mises en production du vendredi soir, les corrections directes sur le serveur, et les écarts entre environnements qui produisent des anomalies impossibles à reproduire.
Sur des copies représentatives, avec des contrôles de volumes, de cohérence et de réversibilité avant toute exécution en production.
Une migration de schéma se teste sur une copie de la production, pas sur une base de développement à cent lignes. Deux choses ne se voient qu’à l’échelle réelle : la durée — un ajout d’index sur une table de plusieurs millions de lignes peut verrouiller pendant plusieurs minutes — et les données non conformes que la nouvelle contrainte refusera.
La réversibilité est écrite pour chaque migration, et testée. Une migration qui ne sait pas revenir en arrière transforme une erreur en incident long.
Nous préférons les migrations compatibles dans les deux sens quand c’est possible : ajouter une colonne, la remplir par un traitement séparé, basculer la lecture, et ne supprimer l’ancienne que plusieurs livraisons plus tard. C’est plus d’étapes et cela permet de livrer sans interruption.
Et pour les transformations de données lourdes, un traitement par lots avec reprise sur interruption plutôt qu’une requête unique qui échoue à quatre-vingt-dix pour cent.
Par le code, la documentation d’architecture, les procédures d’exploitation, les environnements et une passation technique avec vos équipes.
La documentation d’architecture tient en quelques pages et répond à ce qu’un développeur qui arrive demande vraiment : comment lancer le projet en local, où vivent les règles métier, quels sont les traitements asynchrones et ce qui se passe s’ils échouent, quels services externes sont appelés et avec quels secrets, et comment déployer.
S’y ajoutent les décisions d’architecture et leurs raisons — pourquoi ce découpage, pourquoi cette technologie ici. C’est la partie la plus utile et la plus rarement écrite : sans elle, le repreneur défait des choix dont il ignore le motif.
La passation se fait avec vos développeurs, sur le code, deux à quatre demi-journées selon la taille. Pas un diaporama : une lecture guidée du dépôt, un lancement en local ensemble, un déploiement fait par eux sous notre regard.
Si votre équipe technique n’existe pas encore, nous le disons : une application métier sans personne pour la suivre se dégrade, quelle que soit sa qualité initiale.
L’agence web Novatis depuis 2009 conçoit et produit ses projets avec le bureau de production de Montigny-le-Bretonneux, et intervient aussi comme agence web Paris et petite couronne. L’équipe Novatis : l’équipe, l’histoire et la manière de travailler.
Montrez-nous l’existant, les utilisateurs, la fonction prioritaire et les contraintes d’exploitation. Nous cadrerons le point de départ utile.
Organiser le cadrage