Une décision à améliorer
Le cas d’usage part d’un résultat métier observable, pas de la disponibilité d’un modèle ou d’une démonstration spectaculaire.
pour prioriser des projets faisables et utiles
Novatis observe vos processus, données, outils, volumes, exceptions et responsabilités pour distinguer les solutions IA à prototyper, les prérequis à préparer et les idées à écarter pour l’instant.
Vous recevez une feuille de route exploitable : cas d’usage, valeur attendue, faisabilité, risques, architecture probable, critères de test, responsables et prochaine décision.
Le cas d’usage part d’un résultat métier observable, pas de la disponibilité d’un modèle ou d’une démonstration spectaculaire.
Données, documents, historiques, API, droits et compétences disponibles déterminent ce qui peut être testé proprement.
Impact d’une erreur, sensibilité des données, dépendance et contrôle humain orientent le dispositif autant que la performance attendue.
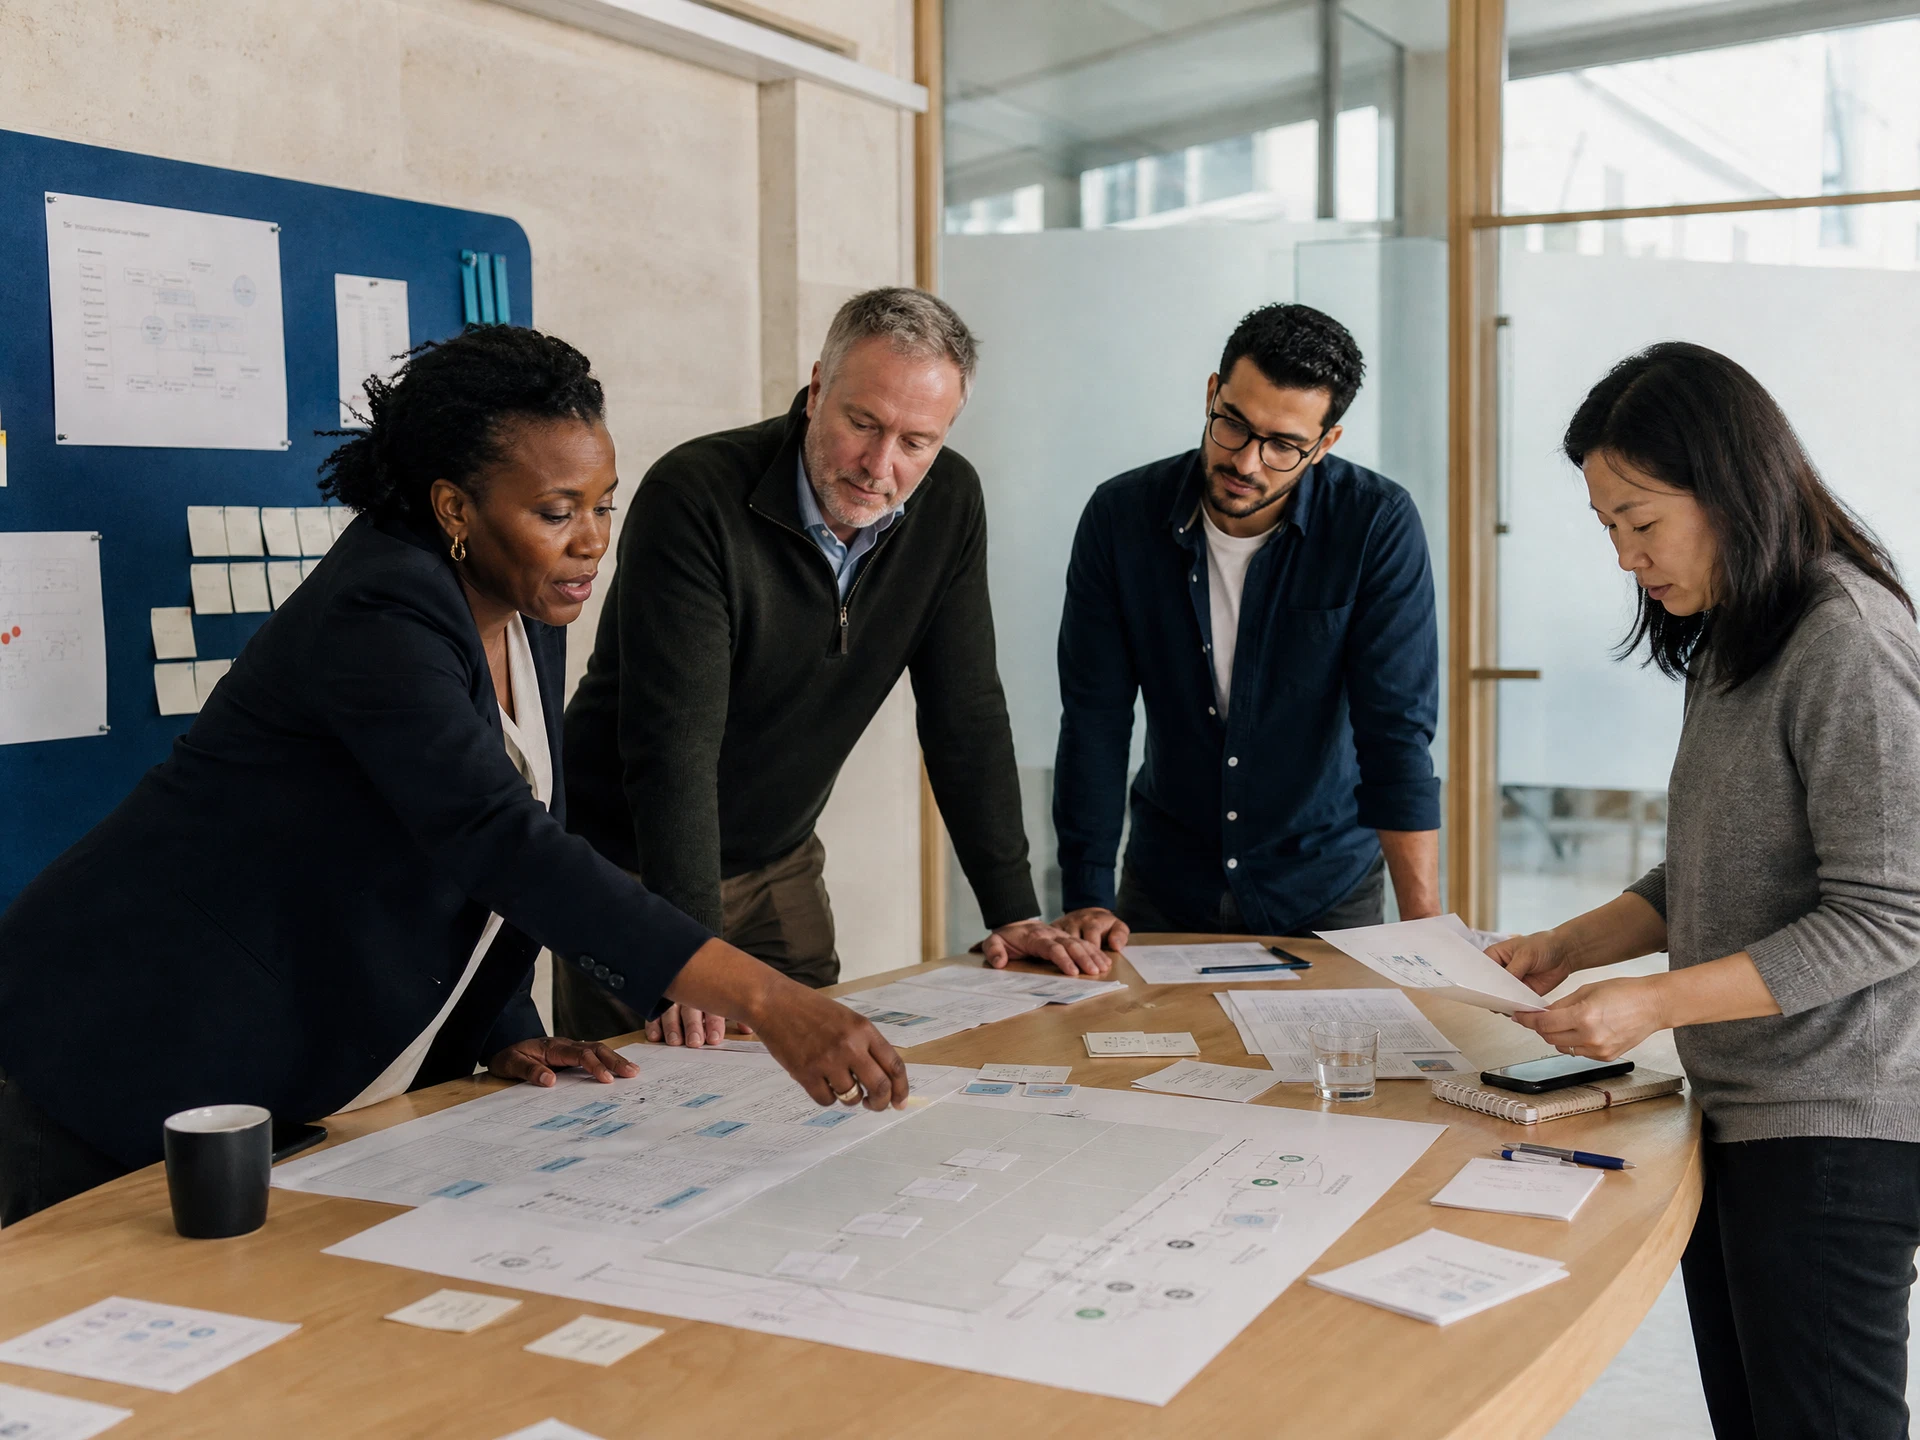
Nous suivons une décision réelle : qui agit aujourd’hui, avec quelles informations, où se trouvent les frictions et quelle erreur serait acceptable. Cette observation évite de chercher une technologie avant d’avoir nommé le problème.
Les sources, volumes, droits d’accès, délais, exceptions et outils sont ensuite rapprochés de la valeur espérée. La feuille de route conserve les inconnues au lieu de les dissimuler dans un score global.
Chaque étape produit une décision lisible par les métiers, la direction et les équipes techniques.
Entretiens, documents, outils, volumes, délais et exceptions décrivent le travail réel plutôt qu’un processus idéal.
Le document final doit permettre de financer, préparer, différer ou refuser un sujet avec des raisons explicites.
Processus, acteurs, informations et conséquences sont reliés pour localiser l’endroit exact où l’IA pourrait assister.
Valeur, données, architecture probable, critères d’évaluation, risques, responsable et prochaine preuve restent réunis.
Dépendances de données, d’intégration, de sécurité et de conduite du changement déterminent un ordre réaliste.
Ces ressources éclairent la conception. Leur présence ne constitue ni une certification de Novatis, ni une conformité automatique du système final.
ISO/IEC 42001 — système de management de l’IACommission européenne — cadre réglementaire de l’IACes articles complètent la page avec des repères de choix, de méthode ou d’exploitation.
Ces témoignages sont reproduits fidèlement depuis la fiche Google publique de Novatis. Ils parlent de qualité d’exécution, de réactivité et, surtout, de relations qui continuent bien après une première mise en ligne.
« Je travaille avec NOVATIS depuis plus de 15 ans. NOVATIS a fait une dizaine de sites internet pendant ces 15 ans pour mes sociétés, en langues française, anglaise et chinoise. NOVATIS est fiable et compétitif, et la communication est facile avec eux. 100% satisfait. »
« Très bonne expérience avec Novatis. L’équipe se distingue par son professionnalisme, sa réactivité et son souci du détail. Le site livré est moderne, rapide et parfaitement structuré. Je recommande vivement. »
« Agence très professionnelle. Équipe réactive, à l’écoute et rigoureuse sur les délais. Le site livré est propre, rapide et bien pensé, avec un vrai accompagnement sur la visibilité et la performance. Je recommande Novatis sans hésiter. »
Source : fiche Google « NOVATIS: Agence Web France », consultée le 5 septembre 2026. Note publique observée : 5,0 sur 5 pour 5 avis.
Les réponses distinguent ce qui peut être conçu, ce qui doit être testé et ce qui dépend de vos données, de vos outils ou de votre cadre de responsabilité.
Poser une question préciseL’audit part des processus réels, des données disponibles et des contraintes. L’idéation produit des idées ; l’audit produit des décisions étayées.
La différence se voit au livrable. Un atelier d’idéation rend une liste de cas d’usage classés par enthousiasme, sans savoir lesquels sont faisables avec vos données. Un audit rend, pour chaque cas envisagé : l’état réel des données nécessaires, la charge de mise en œuvre, le gain estimé avec son hypothèse, le risque réglementaire, et une recommandation de faire ou de ne pas faire.
C’est cette dernière ligne qui manque le plus souvent, et c’est celle qui a de la valeur. Un audit qui recommande de ne rien automatiser sur trois cas sur quatre a fait son travail.
En pratique : deux à cinq jours selon le périmètre, avec des entretiens métier, une inspection des données et un chiffrage. Le résultat vous appartient même si vous ne poursuivez pas avec nous, et il sert de base à une mise en concurrence si vous le souhaitez.
Les personnes qui connaissent le processus, celles qui détiennent les données et celles qui décident. Sans ces trois points de vue, l’audit reste théorique.
Celui qui connaît le processus est indispensable et souvent oublié : il sait ce qui se passe réellement, y compris les contournements et les exceptions que la procédure officielle ignore. C’est dans ces exceptions que se trouvent les raisons pour lesquelles une automatisation échoue.
Celui qui détient les données dit ce qui existe, sous quelle forme, depuis quand et avec quelle fiabilité. Son avis évite les projets fondés sur des données qu’on croyait complètes.
Celui qui décide fixe le critère de réussite et arbitre le niveau de risque acceptable. Sans lui, l’audit produit une recommandation que personne ne peut valider.
Compter trois à six entretiens d’une heure. Nous demandons ces noms au démarrage, avec leurs disponibilités — c’est la contrainte de calendrier la plus fréquente et la moins anticipée.
Par l’analyse de leur complétude, de leur fraîcheur, de leur cohérence, de leur accessibilité et de leur adéquation au cas d’usage envisagé.
Cinq mesures, dans cet ordre. La complétude : quel pourcentage des enregistrements portent réellement le champ nécessaire. La fraîcheur : à quelle date remonte la dernière mise à jour, et quelle part est périmée. La cohérence : un même fait est-il écrit de la même manière — les variantes d’orthographe d’un nom de client suffisent à faire échouer un rapprochement. L’accessibilité : peut-on extraire ces données par un moyen programmable, ou faut-il une intervention manuelle. Et l’adéquation : les données décrivent-elles ce qu’on veut prédire ou retrouver.
Cette dernière question est la plus décisive et la plus négligée. Un historique volumineux mais qui ne contient pas l’information à apprendre ne sert à rien, quelle que soit sa taille.
Le constat habituel : les données existent, elles sont moins bonnes qu’on le croyait, et un chantier de nettoyage précède l’IA. Nous le disons plutôt que de construire sur du sable.
Il propose une estimation étayée par des hypothèses explicites, plutôt qu’une promesse chiffrée sans fondement mesurable.
La méthode : identifier le volume traité, le temps consacré par unité, le coût de ce temps, la part que l’automatisation peut réellement prendre, et le taux d’erreur acceptable. Chaque terme est une hypothèse, chaque hypothèse est écrite, et le résultat est une fourchette.
Ce qui rend ces calculs souvent faux ailleurs : compter le gain sur cent pour cent des cas alors que les exceptions représentent vingt à quarante pour cent et restent manuelles ; oublier le coût de vérification, qui subsiste même quand la production est automatisée ; et ignorer le coût récurrent des modèles, qui se facturent à l’usage.
Nous présentons donc deux scénarios, prudent et favorable, avec les hypothèses qui les séparent. Un client peut ainsi juger sur ce qui lui paraît réaliste plutôt que sur notre optimisme.
Il arrive que le calcul conclue à l’absence de gain. C’est un résultat utile, et il coûte quelques jours plutôt que quelques mois.
Non. Le choix technique vient après la définition du problème, des données et des exigences de qualité, de coût et de confidentialité.
L’ordre inverse est fréquent et coûteux : une organisation souscrit une plateforme, puis cherche quoi en faire. Le résultat habituel est un outil peu utilisé et un abonnement annuel.
Ce qui doit précéder le choix : le problème formulé en termes de décision ou de tâche, les sources autorisées, le niveau de qualité attendu et comment il sera mesuré, les contraintes de confidentialité — vos données peuvent-elles sortir de l’Union européenne —, et le budget récurrent acceptable.
Ces éléments déterminent le choix presque mécaniquement. Une contrainte forte de confidentialité oriente vers un modèle hébergé en Europe ou déployé chez vous. Un volume élevé et une tâche simple orientent vers un petit modèle, nettement moins cher. Une tâche de raisonnement complexe justifie un grand modèle et son coût.
Et ce choix doit rester réversible : nous concevons les systèmes pour que le modèle soit remplaçable.
Oui. L’analyse porte sur les données, les résultats, les usages réels, les risques et la conformité, avec des recommandations concrètes.
Le point de départ est l’usage réel, qui diffère souvent de l’usage prévu : qui s’en sert, combien de fois par semaine, pour quelle tâche, et que font les utilisateurs du résultat. Un assistant consulté trois fois par mois pose un problème d’adoption avant un problème technique.
Vient ensuite la qualité, mesurée plutôt que ressentie : nous constituons un jeu de cas représentatifs avec les réponses attendues, et nous mesurons. Beaucoup de systèmes en production n’ont jamais été évalués ainsi, et le résultat surprend dans les deux sens.
Puis les risques : les sources accessibles au système sont-elles celles qu’on croit, les données sensibles sont-elles exclues, les résultats sont-ils traçables, et une personne peut-elle contester une décision.
Et la conformité, en particulier la classification du système au regard du règlement européen, qui détermine les obligations. Un système utilisé en ressources humaines ou en évaluation de personnes a des exigences que la plupart ignorent.
Par l’identification du rôle joué, de la catégorie de risque du cas d’usage et des obligations correspondantes en matière de documentation, de transparence et de contrôle humain.
Deux questions se posent d’abord. Quel rôle tenez-vous : fournisseur si vous mettez un système sur le marché sous votre nom, déployeur si vous l’utilisez dans votre activité. La majorité des entreprises sont déployeurs, avec des obligations plus légères mais réelles.
Et dans quelle catégorie tombe l’usage. La plupart des cas d’entreprise — assistant documentaire, aide à la rédaction, classement de demandes — relèvent du risque limité, avec une obligation principale de transparence : dire à l’utilisateur qu’il parle à un système. Certains usages basculent en risque élevé, notamment le recrutement, l’évaluation du personnel, l’accès au crédit ou à des services essentiels. Là, les obligations sont substantielles.
L’audit établit cette classification par écrit, avec ce qu’elle implique et le calendrier d’application. Ce n’est pas un avis juridique et nous le disons : sur un cas à risque élevé, nous recommandons de faire valider par un conseil.
Vous disposez d’un diagnostic et d’un plan priorisé. La suite peut être menée par vos équipes, par Novatis ou par un autre prestataire.
Le livrable est conçu pour cela : il décrit chaque cas d’usage retenu avec son périmètre, ses données, ses critères d’acceptation, ses risques et sa charge estimée. C’est un document qui permet de mettre en concurrence, et nous l’assumons — un audit dont le résultat n’est utilisable que par son auteur n’est pas un audit.
La suite recommandée est presque toujours la même : un premier cas d’usage, petit, sur un périmètre où l’erreur est visible et peu coûteuse, avec une évaluation chiffrée avant d’élargir. Nous déconseillons les programmes qui ouvrent quatre chantiers simultanés, parce qu’aucun n’atteint le niveau de qualité nécessaire à l’adoption.
Il arrive que la recommandation soit de ne rien faire pour l’instant — données insuffisantes, processus en cours de refonte, gain incertain. Dans ce cas l’audit a évité une dépense, et c’est le meilleur résultat qu’il pouvait produire.
Nous les suivrons jusqu’aux données, aux exceptions et aux conséquences afin d’identifier ce qui mérite un test — et ce qui n’en mérite pas encore.
Cadrer l’audit IA Preuves, limites et responsabilités explicites